В этой статье
Замеры в статье проведены в октябре 2026 года. Это результаты конкретных серий на тестовых стендах, а не гарантия качества на любом проекте.
В одном из наших тестов ИИ-ревьюер три раза подряд пропустил ошибку в единице измерения. Мы добавили ему один соседний файл - и в следующих трёх запусках он каждый раз нашёл проблему, причём со ссылкой на тесты. Модель и инструкции оставались прежними.
Мы разрабатываем Code Inspect - сервис проверки кода для GitLab, GitFlic и GitVerse. При добавлении поддержки Python, Rust, TypeScript, Java, C# и других языков много времени уходит на сборку контекста: нужно найти код, который поможет проверить изменение. Именно с этим и был связан пропуск.
Ошибка в одной букве
Для теста мы взяли копию fd, утилиты поиска файлов на Rust, и добавили сводку результатов: сколько найдено файлов, каталогов и «больших» файлов. В новом коде стоял такой порог:
use crate::filter::SizeFilter;

/// Size threshold for the "large files" line of the summary: 1 MiB.
const LARGE_FILE: &str = "+1m";
Комментарий обещает один мебибайт - 1 048 576 байт. Но в fd суффикс m означает миллион байт, а мебибайт
записывается как mi. Правильная строка здесь - "+1mi".
Для разработчика, который знает этот проект, ошибка небольшая. Для модели по одному диффу она неочевидна:
соглашение о суффиксах находится в другом файле, size.rs. Там же есть тесты с точными значениями для m и mi.
В режиме «только дифф» модель не заметила расхождение ни разу из трёх. Когда получила size.rs, нашла его
во всех трёх прогонах и сослалась на тесты. Не пришлось менять модель или дописывать в инструкции
«внимательнее проверяй единицы измерения».
Пример подготовлен на копии fd (лицензия MIT). Файл со сводкой мы добавили для теста; в самом fd этого бага нет.
Почему недостаточно открыть импорт
Нужный файл ещё надо найти. Казалось бы, у изменённого кода есть импорт SizeFilter: можно перейти по нему
и передать модели содержимое зависимости.
Но импорт ведёт в filter/mod.rs. Этот файл только перечисляет то, что модуль предоставляет остальному проекту.
Сам SizeFilter, включая правила разбора единиц измерения, объявлен в filter/size.rs.
Если сборщик остановится после первого перехода, модель получит список имён. Строки, по которым можно проверить наш порог, в запрос не попадут.
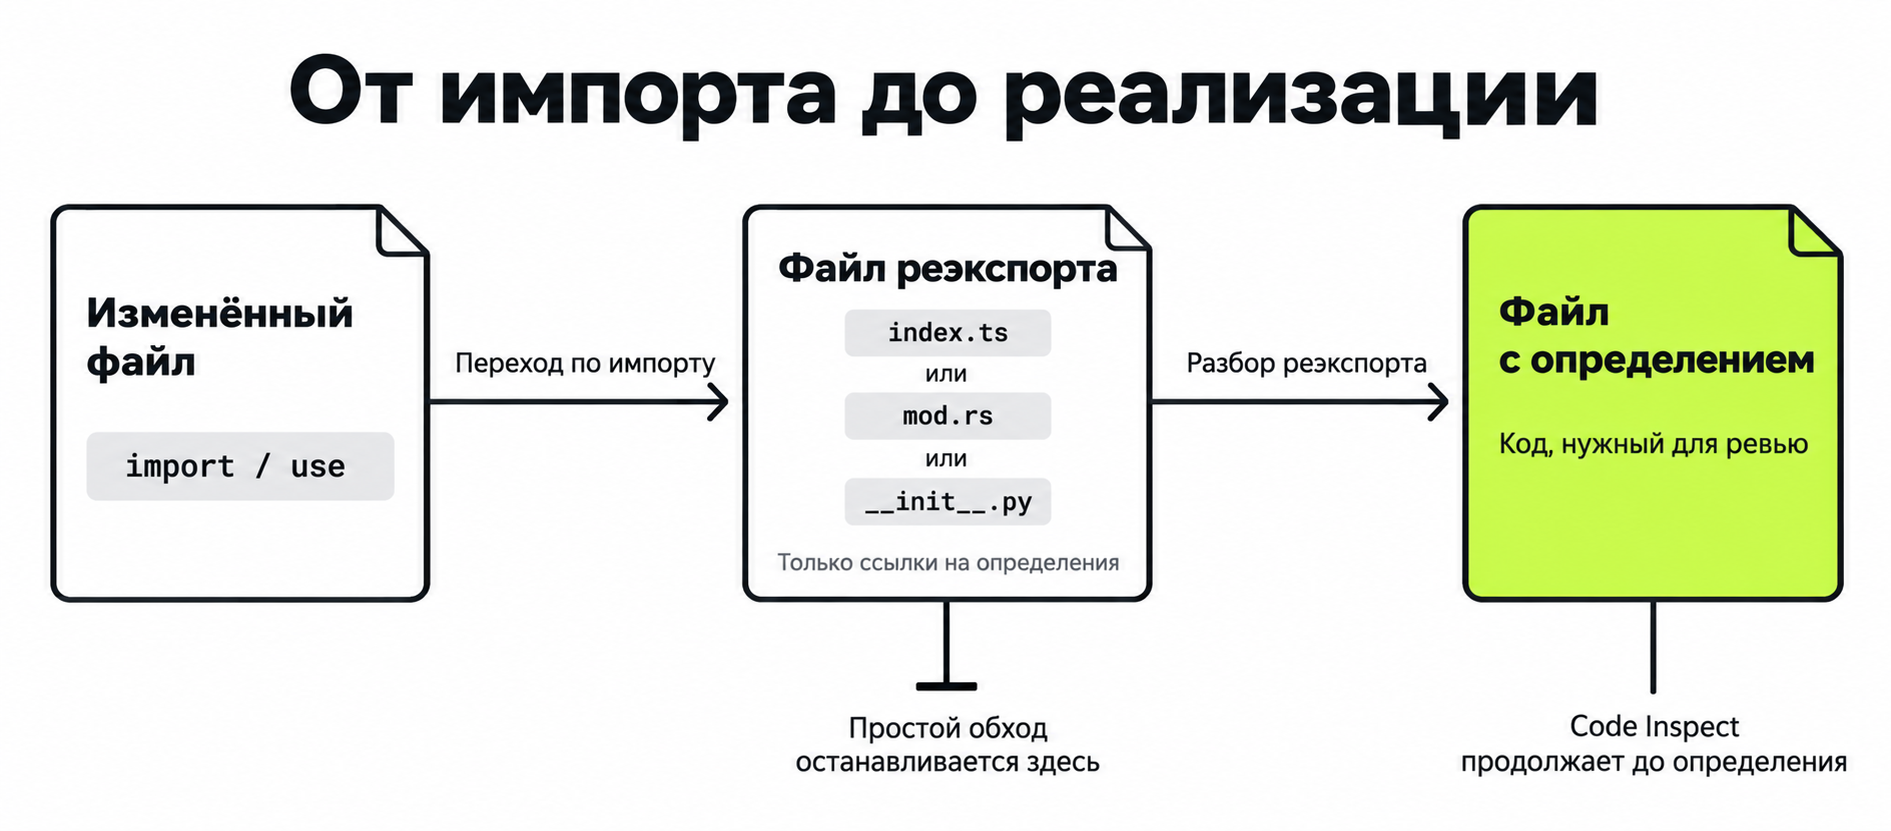
Такой файл называют файлом реэкспорта. Это обычное устройство проекта: в TypeScript похожую роль играет
index.ts, в Python - __init__.py. Разработчик пользуется удобным коротким импортом, а реализация лежит глубже.
Мы посмотрели 18 открытых Rust-репозиториев. В девяти из них через реэкспорт проходило больше трети use.
Для сборщика контекста это частый случай, который приходится обрабатывать специально.
Бывают и связи без прямого импорта нужного класса. Код получает объект из функции, а язык сам выводит его тип. Тогда сборщику нужно посмотреть, что возвращает функция, и уже оттуда перейти к определению класса. На Kotlin-стенде такой дополнительный шаг поднял результат с 9 до 14 успешных попыток из 15. Одного универсального правила «возьми файлы из импортов» нам не хватило.
Насколько это улучшает ревью
После примера с size.rs легко ожидать большого прироста от контекста вообще. На общем наборе он оказался
гораздо скромнее.
Мы подготовили 17 сценариев на копиях открытых проектов и внесли в них 79 дефектов. Сравнили три режима одной модели: только изменения кода; изменения с правилами проекта; Code Inspect, который дополнительно собирает связанные файлы. Для большинства сценариев сделали по три повтора, для двух с огромными сгенерированными файлами - по два.
В среднем за прогон из 79 дефектов нашли:
Только дифф: 70,2.
Дифф и правила проекта: 71,5.
Code Inspect с контекстом: 72,2.
Разница - два дефекта из 79. Большую часть ошибок на этом наборе можно было увидеть в изменённых строках: SQL-инъекции, XSS, утечки ресурсов. Соседний файл для них не требовался.
В межфайловых случаях результат был другим. Например, в Python код сравнивал дату без часового пояса со значением из модели базы данных. Тип колонки был объявлен в соседнем файле. Без него - ни одной находки из трёх попыток, с ним - три из трёх.
Контекст менял и советы по исправлению. В двух MR модель находила XSS во всех режимах, но без связанных файлов
предлагала экранировать вывод или использовать textContent. Code Inspect передавал ей существующую
функцию escapeHtml, и модель советовала воспользоваться ею. Такой совет появился в шести из шести прогонов
с контекстом и ни в одном из шести прогонов каждого из двух остальных режимов.
Это небольшие серии. По ним нельзя обещать такой же результат на любом проекте. Но они позволяют проверить конкретную связь: получила ли модель нужный код и помог ли он найти ошибку или предложить подходящее исправление.
Почему мы не отправляем все файлы
Сборка контекста увеличивает запрос к модели. Его обработка расходует токены и время, а целиком запрос может не поместиться в доступное окно.
На Rust-корпусе подача полных зависимостей требовала по медиане в 4,5 раза больше токенов, чем один дифф. В 331 случае из 711 ревью пришлось бы разбивать на несколько запросов.
На одном PHP-сценарии мы получили ещё и пропуск: сборщик нашёл 81 зависимость, запрос вырос с 6,7 до 87,6 тысячи токенов, а модель перестала замечать дефект, который по одному диффу находила три раза из трёх. По этому эксперименту нельзя установить внутреннюю причину пропуска. Но для нас его достаточно, чтобы не считать увеличение контекста улучшением само по себе.
Поэтому часть зависимостей передаём сокращённо: сигнатуры функций и типы без тел методов. Это снижает объём, но тоже требует проверки. На Kotlin-стенде вместе с телом метода из контекста исчезла и ошибка: с полным кодом модель находила её три раза из трёх, с одними сигнатурами - ни разу.
Приходится разбирать, для чего нужен конкретный файл. Иногда достаточно узнать тип результата функции. Иногда вся проблема находится в её реализации, и сокращение лишает ревью смысла.
Что мы теперь проверяем при пропуске
Если ревьюер не нашёл ожидаемую ошибку, сначала смотрим на отправленный запрос. Был ли там файл с определением? Осталось ли тело нужного метода? Не оказались ли связанные части кода в разных запросах? Если нужный код был в запросе, дальше разбираем, почему модель его не использовала.
Этот порядок пригодился и для ложных замечаний. На рабочем коде sqlx модель заявила, что вызов
spawn_blocking возвращает не тот тип и код не скомпилируется. В репозитории была своя реализация,
отличавшаяся от похожего API, на который опиралось замечание. Когда в запрос добавили файл с этой реализацией,
предупреждение исчезло.
Мы продолжаем проверять сборщик на известных дефектах и коммитах без известных ошибок. Для первого набора важно, что ревью нашло; для второго приходится читать замечания по существу, потому что отсутствие известного бага ещё не делает код безошибочным.
А случай с "+1m" мы оставили на стенде. Он проверяет вполне конкретную вещь: дошёл ли сборщик от удобного
импорта до нескольких строк, без которых нельзя проверить единицу измерения.